Экономия токенов в AI: сравнительное исследование инструментов, техник и фич кэширования
Работайте с ИИ эффективно: как кэширование и сжатие токенов спасают ваш бюджет
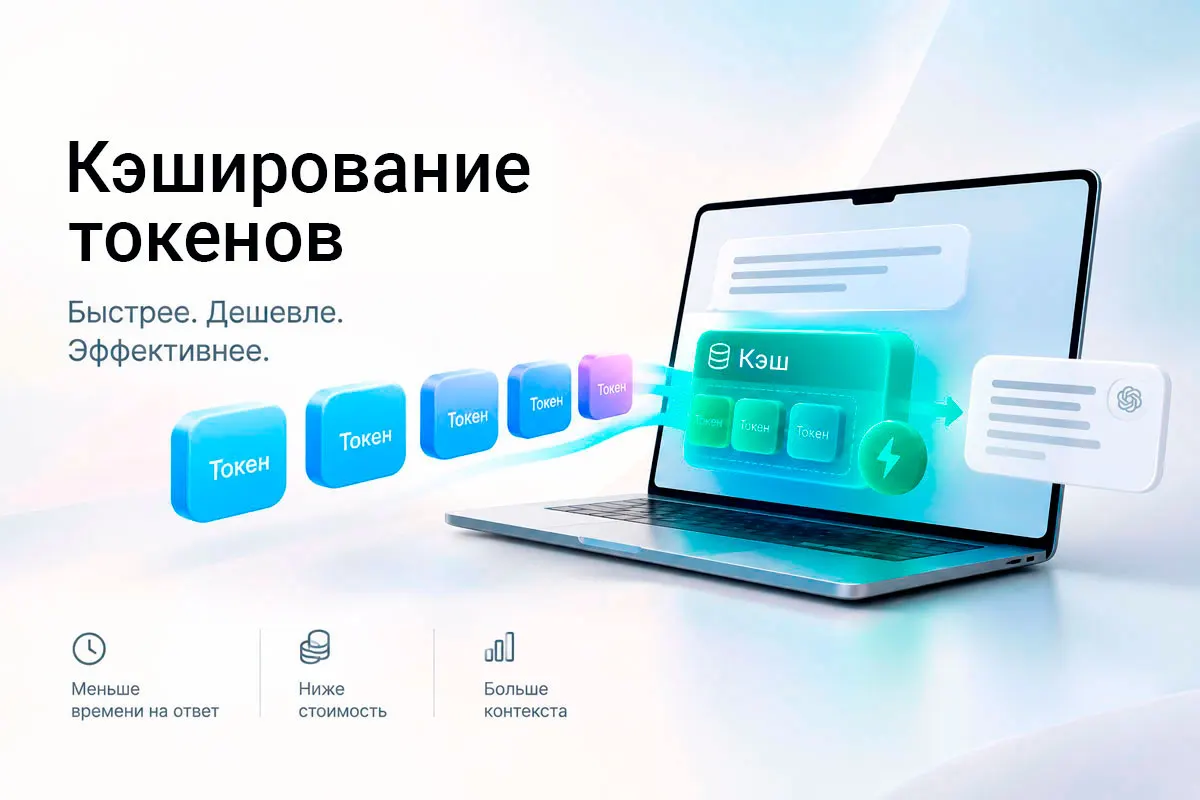
В исследовании рассматриваются практические способы оптимизации расходов и повышения эффективности при взаимодействии с языковыми моделями. Вы узнаете, какие методы позволяют сократить потребление токенов без потери качества ответов, а также как правильно управлять контекстом диалога для более стабильной работы.
Список разделов
Раздел 1: MCP-серверы и агентные фреймворки
Раздел посвящён анализу инструментов и техник, предназначенных для минимизации расходов токенов при взаимодействии LLM с внешними MCP-серверами и агентными экосистемами.
Раздел 2: Промпт-компрессия и семантическое кэширование
Раздел охватывает пять основных алгоритмических подходов к сокращению объема промптов.
Раздел 3: RAG и работа с документами
Раздел посвящён оптимизации контекстного бюджета RAG-систем.
Раздел 4: AI-кодинг ассистенты
Раздел охватывает встроенные механизмы коммерческих редакторов (Claude Code, Cursor, GitHub Copilot, Devin, Cody, Replit Agent) и специализированные open-source/middleware инструменты (Aider, TokenTamer, Repomix).
Отчёт выделяет два наиболее достоверных и верифицированных класса механизмов экономии в кодинге: провайдерское prompt caching (например, в Claude Code с экономией до 90% на кэшированных токенах и ~76% общих входных затрат) и структурное извлечение символов через AST / Tree-sitter с жёстким токен-бюджетом (в частности, Aider Repo Map, сокращающий контекст на ~80%).
Раздел 5: Встроенные провайдерские фичи кэширования
Раздел посвящён анализу нативных архитектурных механизмов кэширования от Anthropic, Google Gemini и OpenAI как единственного класса решений с контрактно гарантированной ценовой экономией.
Раздел 6: Практические рекомендации
Собраны рекомендации по сценариям: Агентная работа, чат-боты, ai-кодинг.
Раздел 7: Компромисс между степенью сжатия и точностью ответов
Анализ ключевых компромиссов и скрытых угроз, которые возникают при попытках агрессивной минимизации токенов. Систематизирует риски деградации качества — от потери критических деталей в логах и семантического дрейфа до роста латентности и галлюцинаций при декодировании.
Итоги исследования
Провайдерское кэширование имеет наивысший ROI.
Provider Caching — это нативный встроенный механизм языковых моделей (LLM) от самих провайдеров (Anthropic, Google Gemini, OpenAI), который сохраняет ранее вычисленный контекст (KV-кэш) и позволяет повторно использовать его в следующих запросах.
Наиболее эффективный подход при работе с оплатой за токены — это многоуровневая архитектурная комбинация техник, где приоритет отдаётся механизмам с гарантированной ценовой математикой и минимальным риском потери качества.
В отличие от сторонних прокси-инструментов, провайдерское кэширование имеет контрактно определённую экономию, зафиксированную в официальной тарифной политике провайдеров.
Anthropic: Предоставляет скидку 90% на повторно читаемые токены (стоимость чтения кэша составляет 0,1x от базовой цены входных токенов).
Google Gemini: Даёт скидку 75–90% на кэшированный входной контекст.
OpenAI: Провайдер автоматически определят и кэширует повторяющиеся префиксы промптов в фоновом режиме без явной разметки со стороны пользователя.
Эффективная работа с кодом: сжатие токенов и экономия подписки
Abstract Syntax Tree, абстрактное синтаксическое дерево в контексте AI-кодинга и оптимизации токенов — это древовидное представление структуры исходного кода, которое используется для структурной навигации и извлечения символов вместо загрузки полных файлов в контекстное окно.
Парсинг кода в AST (часто с помощью библиотеки Tree-sitter) позволяет инструментам глубоко анализировать архитектуру программы и передавать модели только минимально необходимый контекст:
- Скелетонизация кода: Из файлов удаляются полные тела функций и детальные реализации, но сохраняются сигнатуры, типы, импорты и структуры классов.
- Построение карты репозитория: Инструменты вроде Aider парсят код в AST, извлекают связи между символами и ранжируют их алгоритмом PageRank. Это позволяет уместить карту всего репозитория примерно в ~1 000 токенов и сократить расход токенов на ~80%.
- Структурный чанкинг для RAG: Ассистенты, например, Cursor или Devin (Windsurf) разбивают код на чанки строго по синтаксическим границам функций и классов, избегая разрывов логики посреди предложений или блоков.
- Анализ графа зависимостей: Решения вроде ContextDiet и TokenTamer выстраивают граф вызовов по AST и передают в промпт только те пути кода, которые физически достижимы для решаемой задачи.
Механизмы на базе AST применяются в таких инструментах, как Aider Repo Map, Cursor, Devin (Windsurf), Repomix, TokenTamer, Skim и tokendiet-mcp.
Ai CLI и субагенты
AI Command Line Interface — это инструменты командной строки, в которые интегрирован искусственный интеллект.
1. Когда субагенты выгодны (защита контекста)
Субагенты хорошо подходят для автономных подзадач: прогона тестов, сборки проекта, поиска по логам.
Проблема основного чата. Вывод команд попадает в диалог так же, как содержимое файлов, и остаётся там до конца сессии. На каждом следующем шаге эти токены заново отправляются в модель. Провайдерский кэш делает такое чтение дешевле, но не бесплатным, к тому же качество ответов может ухудшаться по мере роста контекста.
Решение через субагента. Субагент работает в собственном чистом контексте и возвращает в основной чат только нужную выжимку, например «все 50 тестов прошли». Со стороны родителя в диалог добавляются только вызов и результат субагента, поэтому кэш родительского диалога остаётся нетронутым.
Когда это работает лучше всего. Когда подзадача порождает больше 1000 токенов, почти все из которых не нужны основной задаче, и заранее понятно, что именно нужно вернуть.
2. Когда субагенты невыгодны (накладные расходы)
Субагенты чаще всего невыгодны на неразделимых, плотно связанных задачах.
Отсутствие наследования. Субагент начинает собственный диалог со своим системным промптом и набором инструментов, поэтому его первый запрос не читает кэш родителя и прогревает свой. Историю родительского чата он автоматически не видит. Исключение: fork наследует системный промпт, инструменты и историю родителя и читает его кэш уже с первого запроса. Ещё одна деталь: у субагентов TTL кэша по умолчанию 5 минут, пока вы не задали другой.
Накладные расходы. Чтобы субагент справился с задачей, требующей контекста, нужно передавать ему вводные данные. Оверхед складывается из дублирования контекста между агентами, координационных сообщений и пересказа результатов при передаче. Точного числа токенов на «запуск окна» Anthropic не публикует, поэтому реальную цену проверяйте по /usage.
По данным Anthropic, мультиагентные реализации обычно тратят в 3–10 раз больше токенов, чем одиночный агент на эквивалентной задаче. Поэтому единую цепочку рассуждений лучше не дробить. Работу стоит делить по границам контекста, а не по типу задачи: последовательные фазы одной работы, тесно связанные компоненты и задачи с общим состоянием оставляйте одному агенту. Например, фичу и её тесты лучше писать в одном контексте.
комментарии доступны в Telegram канале.
AI в SaaS: как бизнесу выжить в эпоху перемен
Как Ai формирует новый рынок SaaS-решений
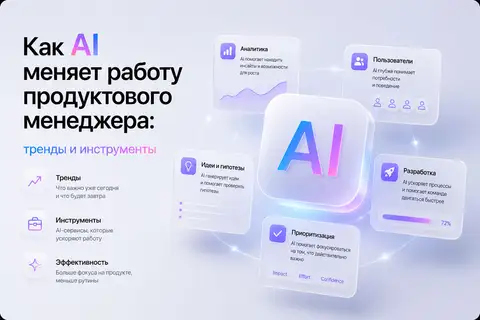
Как AI меняет работу продуктового менеджера: тренды и инструменты
Как Ai трансформирует продуктовый менеджмент.
Кейс Яндекс Директ для хлебопекарного оборудования — заявки по 171 ₽
Кейс продвижения хлебопекарного и кондитерского оборудования в Яндекс Директ. Показываем настройку рекламы и результат: заявки по 171 ₽